Arquitectura de automatización end-to-end · Azure + GCP
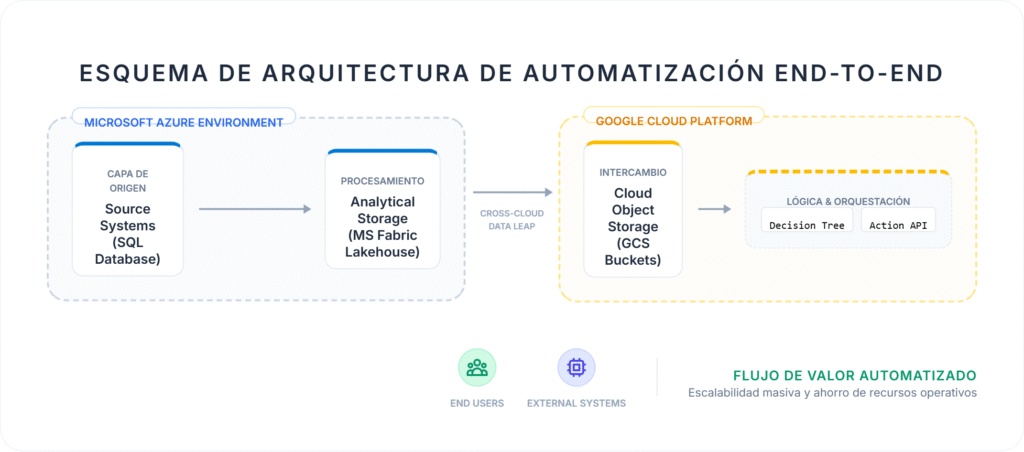
Arquitectura end-to-end que conecta Azure y GCP para convertir datos en acciones automatizadas, eliminando la dependencia humana en cada paso del flujo.
4 fases
Pipeline completo
0h
Supervisión manual
2 nubes
Azure + GCP
∞
Escalabilidad horizontal
En el escenario competitivo actual, el recurso más valioso de una organización es el tiempo de su talento. Sin embargo, muchas empresas sufren un drenaje invisible: profesionales cualificados dedicando horas a procesos manuales repetitivos, validación de registros y traspaso de información entre plataformas.
Es, sobre todo, un problema de coste de oportunidad: cada hora invertida en una tarea que un algoritmo puede resolver es una hora que se resta a la innovación, al análisis estratégico y al crecimiento del negocio.
El principal obstáculo suele ser la fragmentación de sistemas. El dato de origen reside en unas infraestructuras mientras que las herramientas de orquestación y ejecución operan en otras. Esta distancia técnica entre nubes fuerza a las organizaciones a mantener puentes humanos. Esta arquitectura los elimina.
Ingesta inteligente
Extracción limpia desde sistemas centrales mediante Microsoft Fabric. Datos en formato Parquet en el Lakehouse, desacoplando la capa analítica de producción.
El puente seguro
Trasvase íntegramente en memoria hacia Google Cloud Storage. Sin archivos físicos intermedios, sin brechas de seguridad, con autenticación IAM aislada.
Cerebro lógico de decisión
Motor Python con árboles de decisión dinámicos. Clasifica cada registro, genera Jobs estructurados y garantiza idempotencia ante fallos del sistema.
Ejecución masiva vía API
Los Jobs se convierten en impacto real. Escalabilidad horizontal total: 50 registros o 50.000, la infraestructura responde de forma elástica y paralela.
El flujo arranca en el núcleo de la infraestructura de Microsoft, donde Fabric Pipelines extrae los datos de forma limpia y asíncrona, sin exigir a los sistemas transaccionales que procesen ninguna regla de negocio compleja.
El dato se deposita en un Lakehouse bajo formato Parquet. La compresión reduce drásticamente el peso de los archivos, así que los procesos posteriores leen millones de filas en milisegundos sin latencia de disco.
El formato Delta desacopla completamente la capa analítica de la capa de producción del dato crudo. Los sistemas transaccionales no sufren ningún impacto de rendimiento durante el proceso de extracción.
El mayor desafío de una arquitectura Multi-Cloud es el trasvase de información sin comprometer la seguridad ni la integridad del dato. Para conectar Azure con Google Cloud, implementamos una capa de computación distribuida que realiza un traspaso íntegramente en memoria.
Esta arquitectura lee el dato directamente del Lakehouse y lo inyecta en un bucket de Google Cloud Storage a través de flujos cifrados con Spark, sin pasar por carpetas locales intermedias que abrirían brechas de seguridad y alargarían el proceso.
La autenticación se gestiona mediante identidades técnicas aisladas de Google (IAM). Solo los procesos autorizados pueden realizar este "apretón de manos" entre nubes. Ningún archivo toca disco en ningún momento del proceso.
Una vez el dato reside en el ecosistema de Google, un orquestador Airflow activa el componente más crítico: el motor lógico, que decide qué hacer con cada registro entrante.
Utilizando un árbol de decisiones dinámico, el sistema analiza cada registro para determinar su prioridad, su canal de salida y el momento óptimo de ejecución, y genera como salida una serie de Jobs, paquetes estructurados con todos los metadatos necesarios para que la ejecución final se complete sin fricción.
El sistema incorpora idempotencia de fábrica. Si ocurre un fallo durante el proceso, sabe exactamente dónde se detuvo y lo reanuda sin duplicar acciones ni perder información.
El motor lógico es agnóstico al proveedor. Hoy inyecta metadatos en una API de mailing, pero la arquitectura está preparada para disparar notificaciones push, SMS o actualizaciones en un CRM simultáneamente.
La etapa final convierte los Jobs en impacto real. El sistema consume los metadatos ya preparados en la fase anterior y dispara el envío sin recalcular ninguna lógica sobre la marcha.
Este diseño permite una escalabilidad horizontal total. Ya sea que necesitemos accionar 50 registros o 50.000, la infraestructura responde de forma elástica, disparando miles de procesos en paralelo con una monitorización detallada de cada respuesta recibida.
El círculo se cierra cuando el dato analítico estático se convierte en una acción operativa finalizada con éxito. Sin que nadie haya pulsado un botón.
¿Te suena este problema?
Eso es exactamente lo que resuelve esta arquitectura. Hablamos 30 minutos y vemos si tiene sentido aplicarla a tu caso.
Agenda una llamada